Нейросеть для работы с текстом
Распознать текст с фото нейросетью
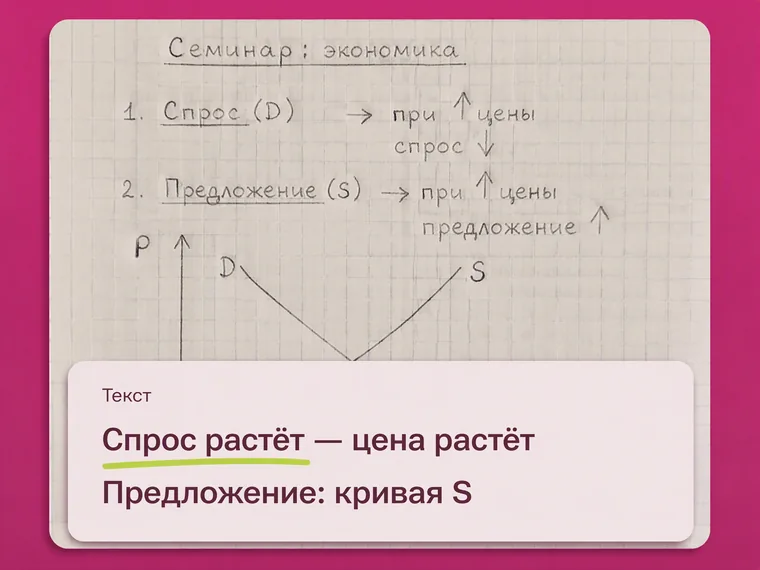
Нейросеть переносит текст со снимка или скриншота в редактируемый вид с абзацами, списками и таблицами. Подходит для конспектов, книг, чеков и сканов договоров. По запросу модель пишет дословно, без пересказа.
- Пробный доступ: 0 ₽, 24 часа
- 12 операций и 50 токенов
- Оплата картой РФ, без VPN
Суммы, реквизиты и фамилии сверяйте с оригиналом: модель может заменить символ правдоподобным. Где нужна сверка
Где нейросеть читает надёжно, а где нужна сверка
Текст с фото читает мультимодальная модель — нейросеть, которая понимает изображения. Она не копирует символы, а восстанавливает текст по смыслу: связную речь читает уверенно, а в редкой фамилии или номере счёта может подставить правдоподобный, но неверный вариант.
Тексты, где ошибка в символе стоит дорого
Здесь распознанный текст — черновик для сверки, а не готовые данные. Ошибка модели выглядит как обычное слово или число, и проверка орфографии её не подчеркнёт. Каждую цифру и каждое имя сверяйте с оригиналом.
-
Банковские реквизиты и суммы
Одна неверная цифра в БИК или номере счёта отправит платёж не туда.
-
Паспорт, СНИЛС, полис ОМС
Чужие данные загружайте только с согласия владельца — этого требует 152-ФЗ.
-
Договоры и доверенности
Юридическую силу имеет подписанный оригинал, а не распознанная версия.
-
Рецепты и медицинские выписки
Название препарата и дозировку сверяйте с оригиналом и уточняйте у врача.
-
Неразборчивый почерк
Модель достраивает слово по контексту и не всегда помечает сомнение.
Задачи, где распознавание экономит часы
В этих задачах хватит выборочной проверки: смысл сохраняется, а случайную опечатку видно при чтении. Чтобы модель не правила текст автора, добавьте в запрос «дословно, без исправлений». Права на текст книги или статьи остаются у автора, поэтому распознанная копия годится для личной работы, а публикация требует разрешения.
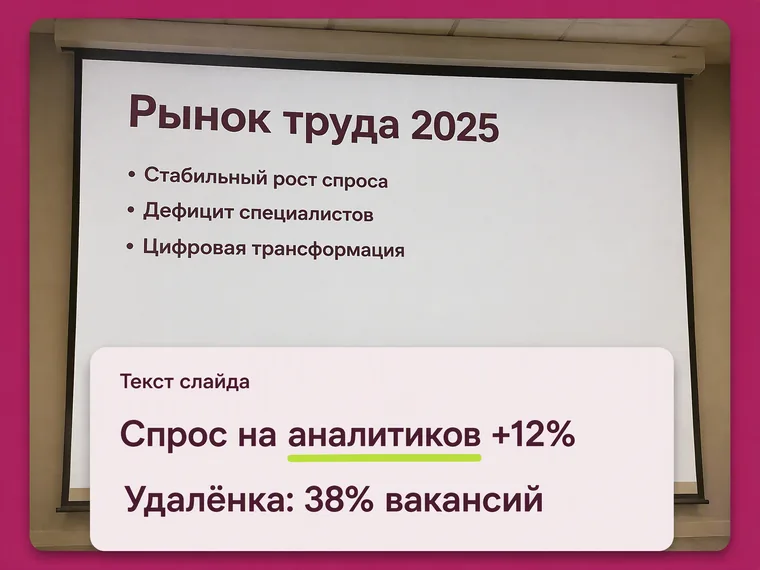
Слайды презентации с занятия
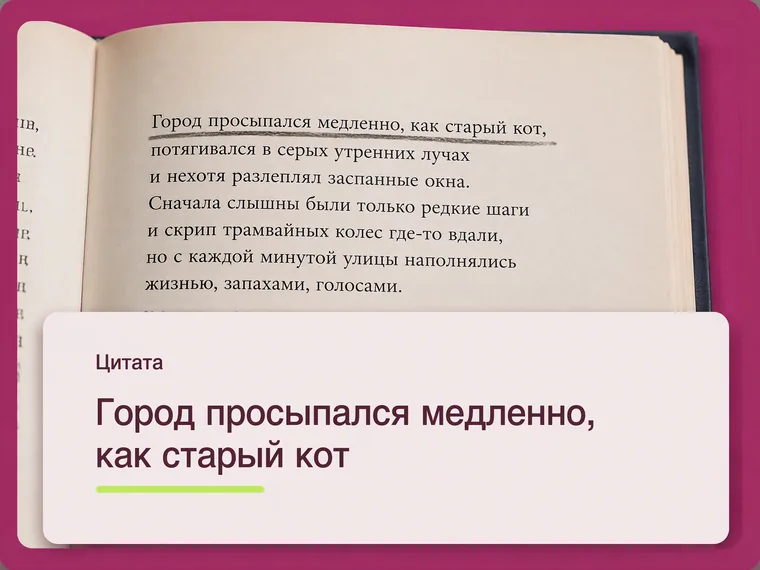
Страница книги для цитирования
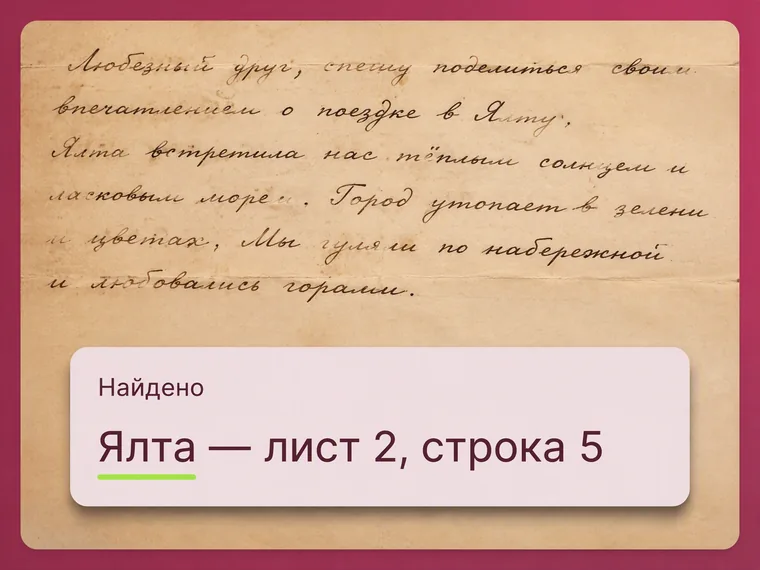
Скан письма для поиска слов
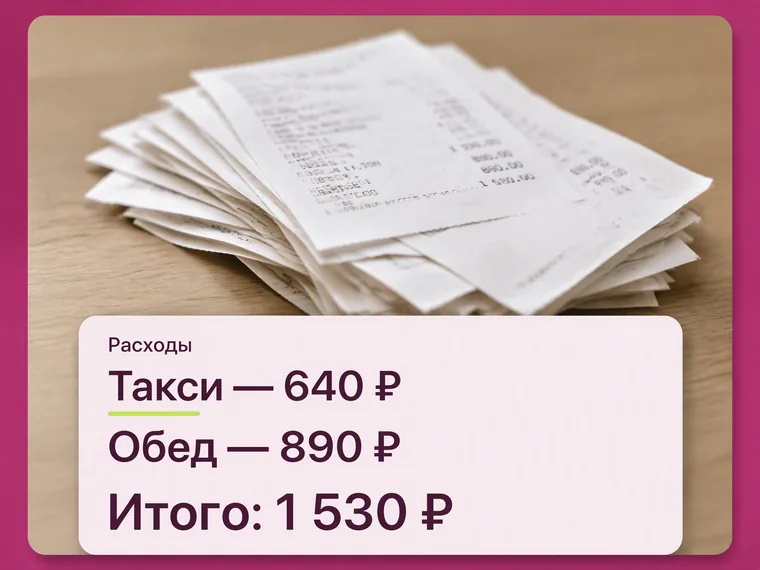
Чеки для отчёта по расходам
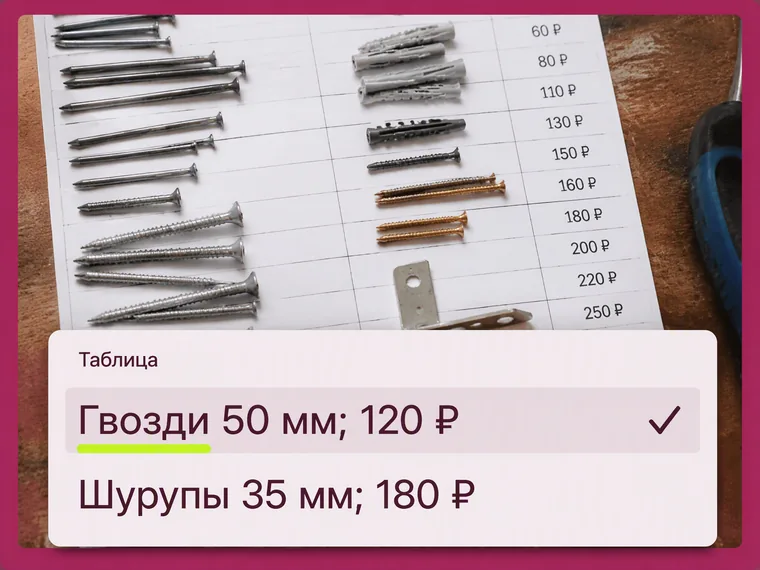
Прайс или накладная в таблицу
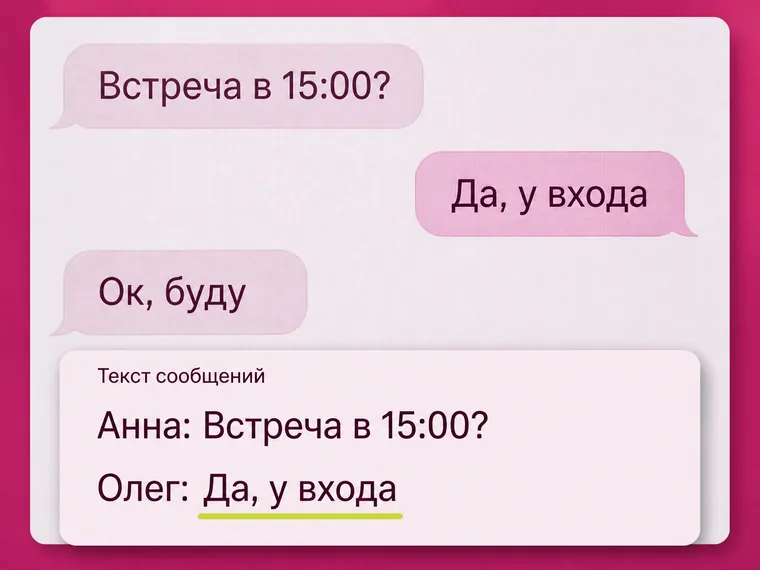
Скриншот переписки или сайта
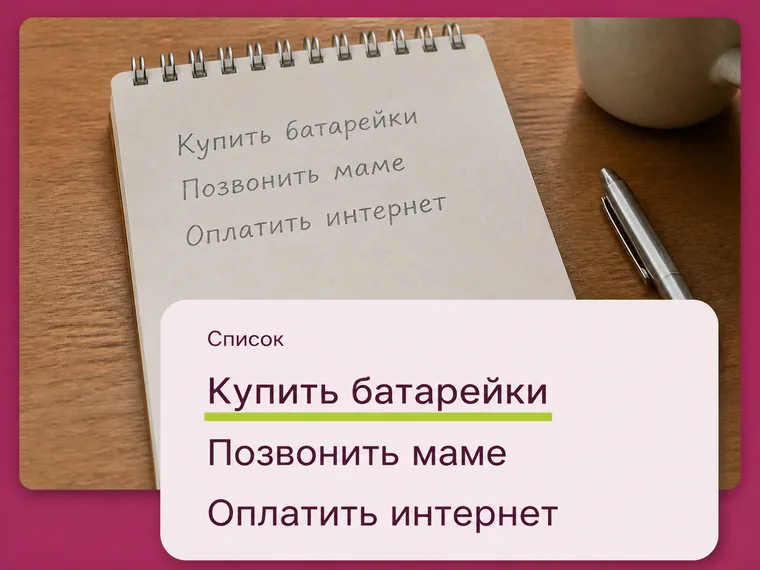
Рукописные заметки и списки
Как оформить результат в таблицу или конспект
Для документа, где важен каждый символ, распознавание — только первый шаг: дальше идёт сверка спорных мест тремя приёмами. Сверка спорных мест и цифр
Настройки распознавания по типу текста
Параметры подходят для любой модели раздела «Нейросети», которая принимает изображения.
Печатный текст
Страница книги или журнала
Сверка имён, дат и цитат- Исходник
- Одна страница в кадре, разворот — двумя снимками
- Кадр
- Камера параллельна листу, страница прижата у корешка
- Запрос
- «Дословно, сохрани абзацы и сноски, неясное помечай [?]»
- Результат
- Текст с абзацами, сноски — списком в конце
- Сверить
- Имена, даты, цитаты и номера страниц
Печатный текст
Договор, письмо или скан
Сверка реквизитов обязательна- Исходник
- Каждая страница — отдельный снимок
- Кадр
- Лист целиком с полями, без тени от телефона
- Запрос
- «Дословно, сохрани нумерацию пунктов и реквизиты»
- Результат
- Текст с нумерацией пунктов и блоком реквизитов
- Сверить
- Суммы, даты, ИНН, БИК и номера счетов
Печатный текст
Паспорт, СНИЛС или полис
Только свои данные или с согласия- Исходник
- Страница с нужными полями, лишнее закрыто листом
- Кадр
- Без бликов от ламината и голограммы
- Запрос
- «Выпиши поля: ФИО, дата рождения, серия, номер»
- Результат
- Список в формате «поле — значение»
- Сверить
- Каждую цифру номера, даты и написание фамилии
Распознанный текст не заменяет копию документа и не имеет её юридической силы.
Рукописный текст
Конспект и записи от руки
Сверка терминов и слов с [?]- Исходник
- Тёмная ручка на светлой бумаге, одна страница
- Кадр
- Без пальцев и теней на строках
- Запрос
- «Дословно, сокращения не раскрывай, неясное помечай [?]»
- Результат
- Текст с нумерацией пунктов и переносами автора
- Сверить
- Термины, формулы, фамилии и слова с пометкой [?]
Рукописный текст
Бланк, заполненный от руки
Сверка обязательна- Исходник
- Бланк целиком: печатные подписи полей помогают модели
- Кадр
- Лист расправлен, все поля в кадре
- Запрос
- «Выпиши поля и значения, пустые поля отметь»
- Результат
- Пары «поле — значение», пустые поля отмечены
- Сверить
- Цифры, даты и фамилии, вписанные от руки
Таблицы и чеки
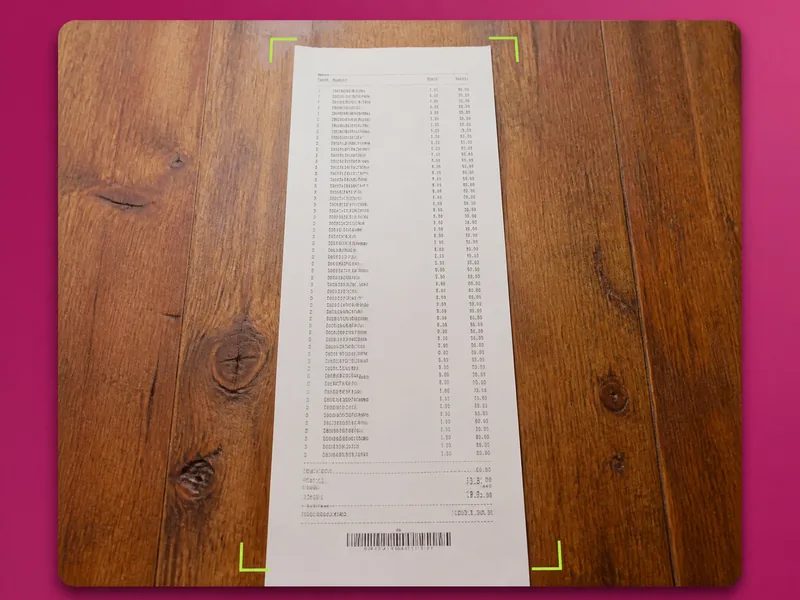
Кассовый чек или квитанция
Сверка итога и сумм- Исходник
- Чек целиком, длинный — двумя снимками с перекрытием
- Кадр
- Бумага расправлена, выцветшие строки видны
- Запрос
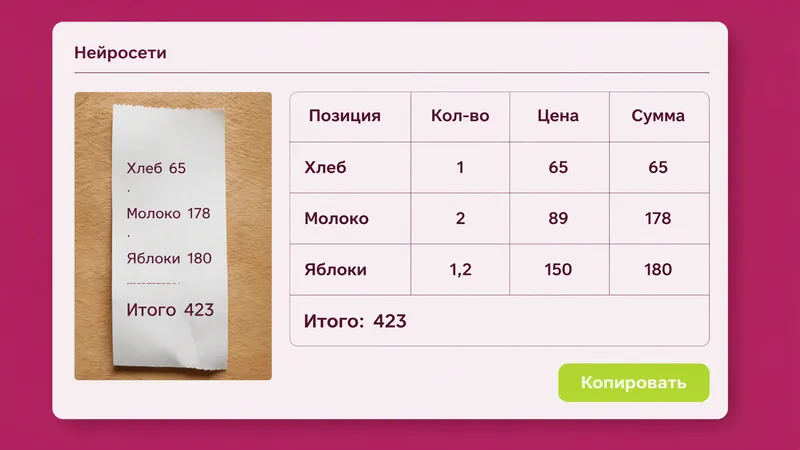
- «Сведи в таблицу: позиция, количество, цена, сумма»
- Результат
- Таблица позиций и отдельная строка итога
- Сверить
- Попросите сложить строки и сравнить сумму с итогом
Таблицы и чеки
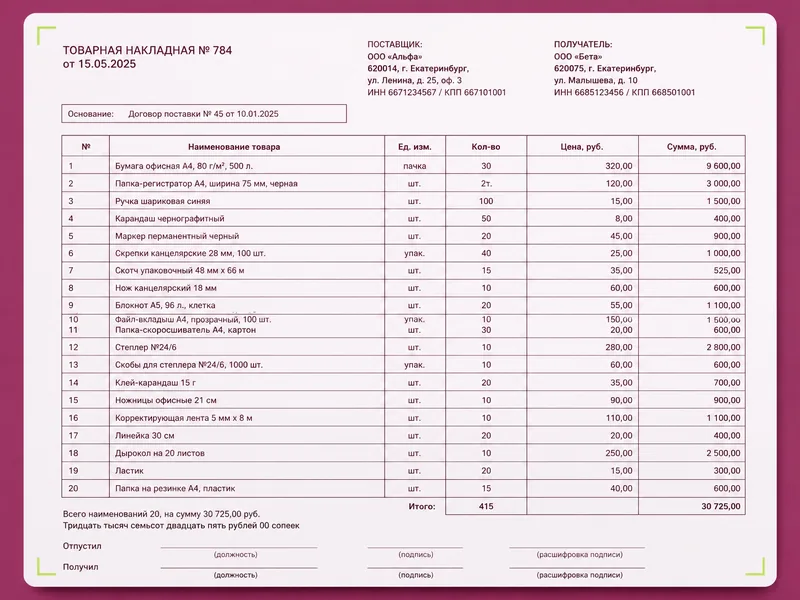
Таблица, накладная или прайс
Сверка столбцов- Исходник
- Таблица с шапкой, широкая — частями с повтором шапки
- Кадр
- Линии таблицы параллельны краям кадра
- Запрос
- «Перенеси таблицей, пустые ячейки оставь пустыми»
- Результат
- Таблица, для Excel — значения через точку с запятой
- Сверить
- Сдвиги значений между столбцами, объединённые ячейки
С экрана
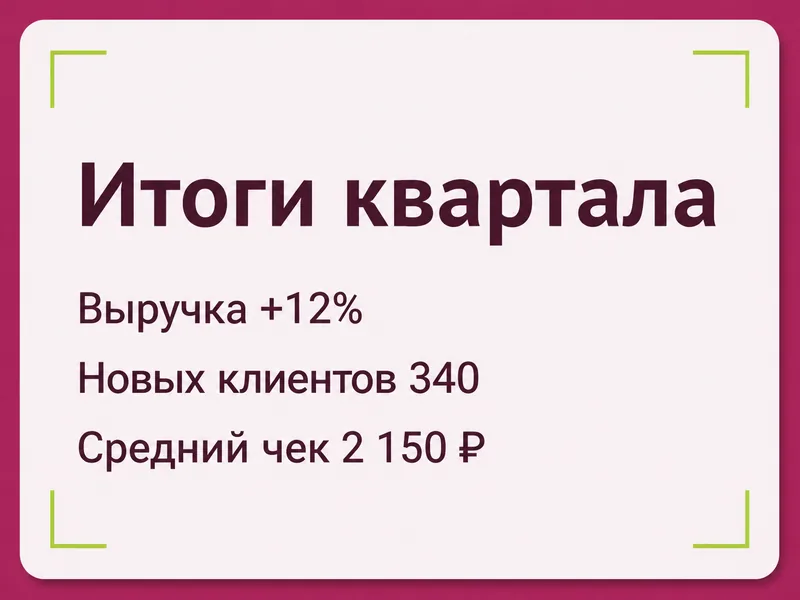
Скриншот, слайд или экран
Выборочная сверка- Исходник
- Скриншот вместо фото экрана: нет ряби от пикселей
- Кадр
- Только нужная область, панели интерфейса обрезаны
- Запрос
- «Перепиши текст слайда, заголовки выдели отдельно»
- Результат
- Текст с заголовками и списками, как на слайде
- Сверить
- Ссылки, адреса, коды и имена файлов
Как идёт работа: три шага
Порядок один для конспекта, книги, чека и скриншота: открыть шаблон, подать снимок с условиями и запустить. Для реквизитов, сумм и документов с личными данными к этому добавляется сверка спорных мест.
01 Шаблон распознавания текста
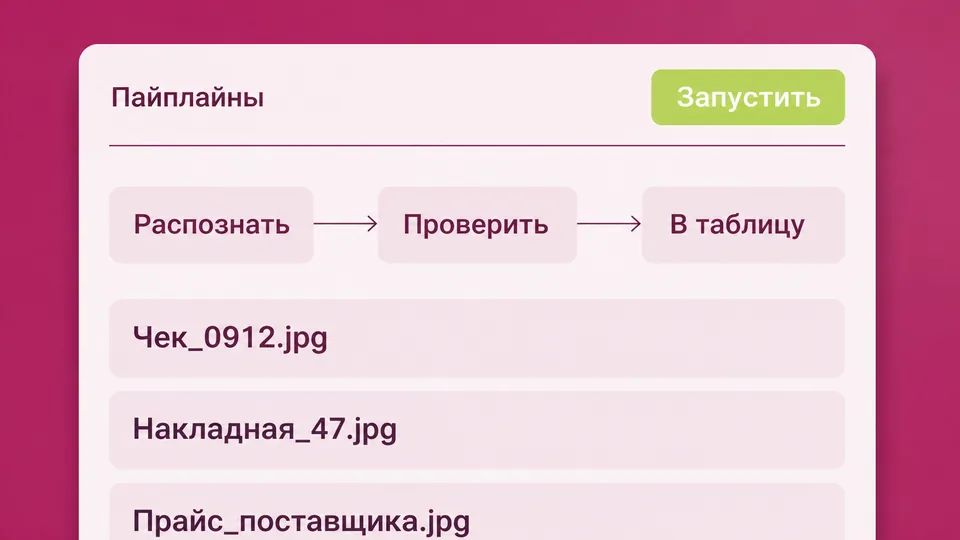
Откройте шаблон распознавания в разделе «Нейросети» или «Пайплайны». Промпт с нуля писать не нужно: порядок работы уже задан, вы подставляете свой снимок. Один шаблон и читает текст, и раскладывает его так, как вы попросили во вводных.
02 Вводные: снимок и условия
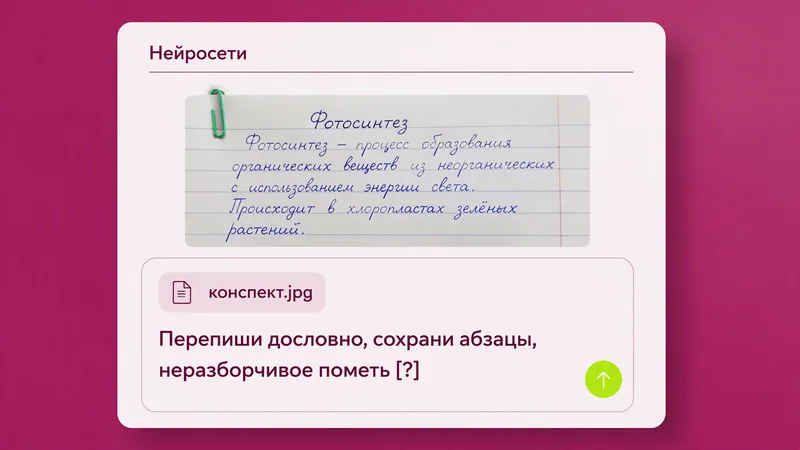
Подайте снимок — файлом или просто текстом, если он уже набран: JPG, PNG, WEBP или HEIC до 15 МБ. Задайте условия: переписать дословно, сохранить структуру, пометить неразборчивое. Без них длинная страница может прийти сокращённой, а орфография автора — исправленной.
03 Запуск и готовый текст
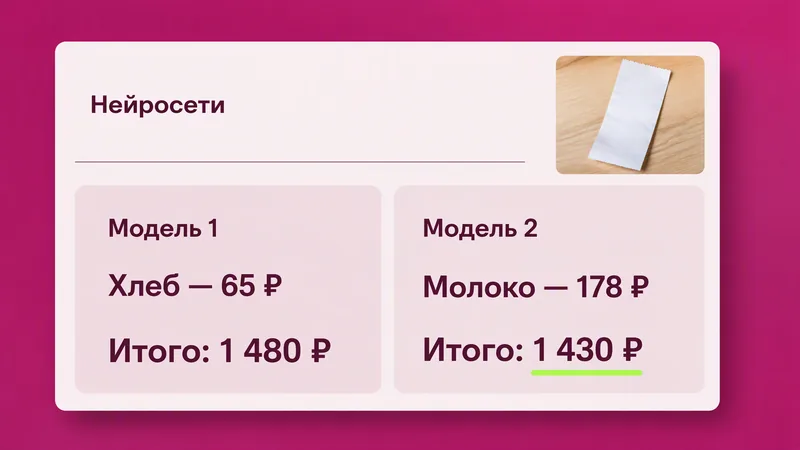
Запустите шаблон и заберите текст. Спорные места сверяют отдельным запуском: просят перечислить слова и числа, в которых модель не уверена, и прогоняют тот же снимок другой моделью — расхождение показывает ошибку.
Как сфотографировать текст для распознавания
Точность распознавания задаёт исходник: слово, размытое на снимке, модель не читает, а угадывает. Съёмка по правилам ниже занимает меньше минуты и заранее убирает причины ошибок, разобранных дальше на странице.
Свет, угол съёмки и расстояние
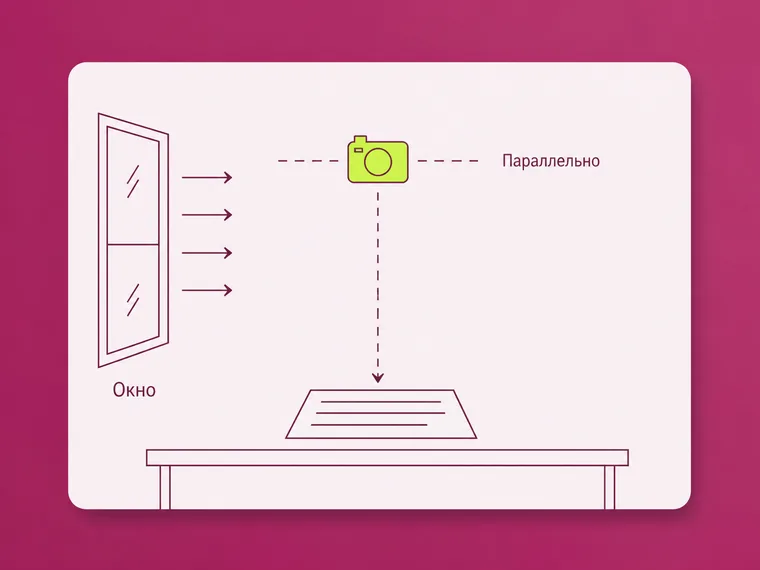
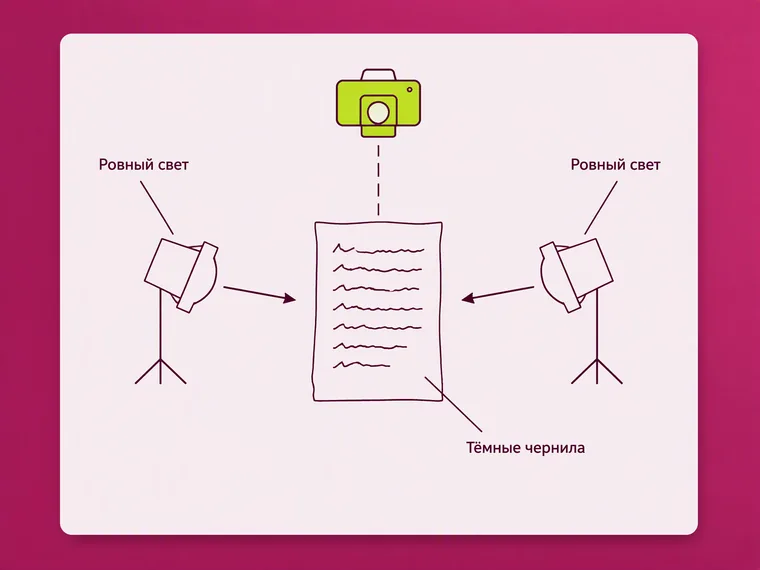
Снимайте при рассеянном дневном свете или с лампой сбоку: вспышка оставляет блик на глянцевой бумаге. Держите телефон параллельно странице, иначе строки сойдутся трапецией и дальний край размоется. Страница должна занимать почти весь кадр, с узкими полями по краям. Перед снимком коснитесь текста на экране для фокусировки и не двигайте руку до щелчка затвора.
Изгиб страницы, блики и мелкий шрифт
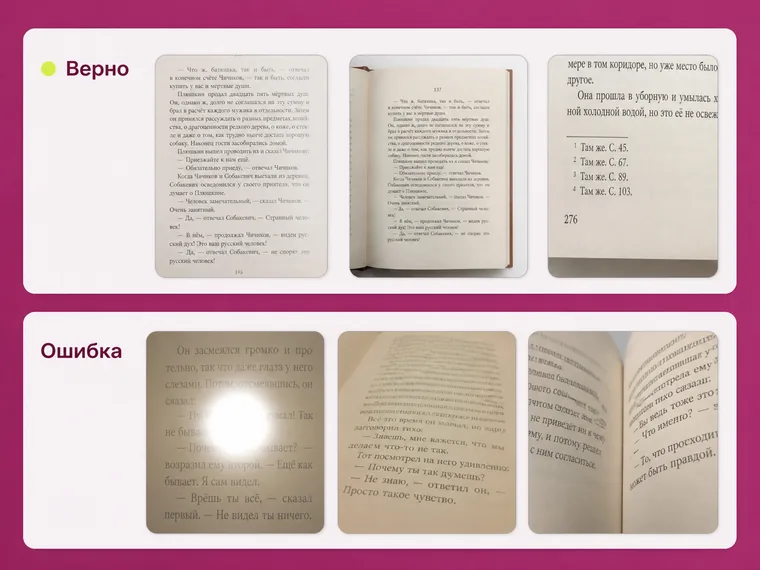
Книгу у корешка прижмите ладонями или стеклом: изогнутые строки модель читает с пропусками. Глянцевую страницу наклоните так, чтобы блик от лампы ушёл за край листа. Мелкий шрифт, сноски и примечания снимайте отдельным кадром крупнее. С экрана делайте скриншот, а не фото: камера ловит муар — рябь от пикселей экрана.
Рукописи и старые документы
Рукопись снимайте при ярком ровном свете: чёрная или синяя ручка на белом листе контрастнее карандаша. При неразборчивом почерке попросите модель помечать сомнительные слова, а не угадывать их. Для текста в дореформенной орфографии укажите, сохранять ли букву «ѣ» или писать современно. Выцветшие чернила сначала проявите инструментом улучшения качества.
Примеры: снимок и распознанный текст
В кадре — снимок, который загрузили, под ним — текст, который с него читают. Сверьте текст с кадром: он переносится слово в слово, меняется только то, что названо в условиях.
- JPG · 4:3
Книги и статьи
Страница книги · абзац без правок
Текст со снимка: Дождь начался внезапно, и площадь опустела за минуту. Старик у фонтана сложил газету и двинулся к арке. Вода шумела так громко, что шагов его никто не услышал. Абзац перенесён слово в слово, с авторской пунктуацией: запятые, точки и прописные буквы — как на странице. Переносы строк книги в тексте не сохраняются: строка там кончается по ширине полосы, а не по смыслу.
Книги и статьи
Страница книги · абзац без правок
Текст со снимка: Дождь начался внезапно, и площадь опустела за минуту. Старик у фонтана сложил газету и двинулся к арке. Вода шумела так громко, что шагов его никто не услышал. Абзац перенесён слово в слово, с авторской пунктуацией: запятые, точки и прописные буквы — как на странице. Переносы строк книги в тексте не сохраняются: строка там кончается по ширине полосы, а не по смыслу.
- JPG · 4:3
Чеки и таблицы
Накладная · таблица позиций
Текст со снимка: Накладная № 147 Наименование; Кол-во; Цена Бумага А4; 5; 320 Папка-регистратор; 12; 180 Маркер; 20; 45 Итого: 4 540 Колонки разделены точкой с запятой — такую строку вставляют в Excel без разбора по ячейкам вручную. Шапка и значения не сдвинуты: количество осталось количеством, цена — ценой.
Чеки и таблицы
Накладная · таблица позиций
Текст со снимка: Накладная № 147 Наименование; Кол-во; Цена Бумага А4; 5; 320 Папка-регистратор; 12; 180 Маркер; 20; 45 Итого: 4 540 Колонки разделены точкой с запятой — такую строку вставляют в Excel без разбора по ячейкам вручную. Шапка и значения не сдвинуты: количество осталось количеством, цена — ценой.
- JPG · 4:3
Чеки и таблицы
Кассовый чек · позиции и итог
Текст со снимка: КОФЕЙНЯ У ПАРКА Капучино 320 Круассан 180 Вода 90 ИТОГО 590 Позиции и суммы стоят парами, итог вынесен отдельной строкой — чек сразу годится для отчёта о расходах. Названия перенесены так, как напечатаны на ленте: «Капучино» с одной «ч», как в чеке.
Чеки и таблицы
Кассовый чек · позиции и итог
Текст со снимка: КОФЕЙНЯ У ПАРКА Капучино 320 Круассан 180 Вода 90 ИТОГО 590 Позиции и суммы стоят парами, итог вынесен отдельной строкой — чек сразу годится для отчёта о расходах. Названия перенесены так, как напечатаны на ленте: «Капучино» с одной «ч», как в чеке.
Почему появляются ошибки и как их исправить
Ошибка распознавания заметна не сразу: опечатка в фамилии уходит в приказ, лишняя цифра — в отчёт о расходах, неверный БИК — в платёжное поручение. Каждую причину из перечня устраняет одно действие: переснять кадр, уточнить запрос или подготовить снимок.
Какие нейросети распознают текст в 24AI
В разделе «Нейросети» текст с фото читают модели нескольких разработчиков, и переключаться между ними можно перед запуском, баланс один. Второй разработчик нужен для сверки: сравнение двух ответов показывает места, где ошибается хотя бы одна модель.
GPT от OpenAI
GPT 6.1 Sol, 6 Luna, 5.5 Pro и другиеClaude от Anthropic
Claude 5.5 Opus, 5.5 Sonnet, 5.1 Fable и другиеGemini от Google
Gemini 3.8 Flash, 3.7 Flash, 3.1 Pro и другиеDeepSeek
DeepSeek V4.1 Flash, V4 Pro, V4 Flash и другиеGrok от xAI
Grok 4.7, 4.6, 4.5 и другиеQwen от Alibaba
Qwen 3.8 Max, 3.8 Flash, 3.7 Max и другиеKimi от Moonshot AI
Kimi K3, K2.7 Code, K2.6 и другиеПеречень моделей задаёт сервис и обновляет его при выходе новых версий; актуальный список моделей смотрите в сервисе. Полный список моделей доступен на всех платных тарифах. Размытый или мелкий текст перед распознаванием подтягивает собственная модель 24AI — «Увеличение разрешения».
Хранение фото документов и права на текст
Фото паспорта, договора или медицинской выписки содержит персональные данные. Загружайте свои документы или документы людей, которые согласились на обработку; поля, которые распознавать не нужно, закройте листом перед съёмкой.
Запросы обрабатывают внешние модели
Снимок и ваши условия уходят внешней модели на стороне её разработчика — GPT, Claude, Gemini и другим. Персональные данные третьих лиц и коммерческую тайну без основания не загружают: сервис такого основания не заменяет.
Права на результат
Исключительные права на созданные материалы принадлежат владельцу аккаунта: распознанный текст можно использовать в работе и в коммерческих материалах без отдельного разрешения сервиса.
Ответственность за содержание
За законность опубликованного и за права на исходные материалы отвечает владелец аккаунта, а не сервис.
Правообладатель сервиса 24AI
- ООО «Архивариус»
- ИНН 5408024261
- ОГРН 1195476051891
- 630090, Новосибирск, ул. Николаева, зд. 11/1
- Аккредитованная ИТ-компания, резидент Академпарка
- Владелец сервиса — АО «Точка»
Стоимость и сравнение с другими способами
Способ получить текст с фото выбирают по четырём величинам: цена, время на страницу, число повторов и риск пропустить ошибку в цифре. Подписка решает первую, а остальные зависят от объёма и типа текста.
| Критерий |  Мультимодальная модель читает фото, скриншот и рукопись, а следующим запросом превращает текст в таблицу, конспект или перевод. Работает в браузере на любом устройстве, установка не нужна. | Программа OCR OCR — оптическое распознавание символов: программа читает текст знак за знаком и сохраняет разметку страницы. Для многостраничных сканов и архивов она быстрее, а сомнительные символы многие программы подсвечивают. | Набор вручную Две-три строки быстрее перепечатать, чем снять, загрузить и сверить. Вручную надёжнее разобрать и короткую неразборчивую запись, если рядом автор, который подскажет слово. |
|---|---|---|---|
| Ориентир | От 999 ₽ в месяц, тариф «Стартовый»ответ за минуты | Бесплатные и платные версии, цена зависит от лицензии | Без затрат, но каждая страница стоит времени набора |
| Даёт | Чтение рукописей и сложных снимковТаблицу и перевод в том же чатеРаботу без VPN с оплатой картой РФ | Пакетную обработку многостраничных PDFСохранение колонок, шрифтов и полейРаботу без интернета в версиях для ПК | Контроль каждого символа при набореНикаких загрузок чужих данныхСкорость на двух-трёх строках текста |
| Не даёт | Дословности без сверки цифр и имёнЗагрузки PDF: принимает только фотоРаботы без подключения к интернету | Уверенного чтения рукописного текстаПеревода и конспекта по запросуУстойчивости к бликам и изгибу листа | Скорости на многостраничном текстеЗащиты от опечаток при набореТаблиц и перевода без лишней работы |
Мультимодальная модель читает фото, скриншот и рукопись, а следующим запросом превращает текст в таблицу, конспект или перевод. Работает в браузере на любом устройстве, установка не нужна.
- Ориентир
- От 999 ₽ в месяц, тариф «Стартовый»ответ за минуты
- Даёт
- Чтение рукописей и сложных снимковТаблицу и перевод в том же чатеРаботу без VPN с оплатой картой РФ
- Не даёт
- Дословности без сверки цифр и имёнЗагрузки PDF: принимает только фотоРаботы без подключения к интернету
Программа OCR
OCR — оптическое распознавание символов: программа читает текст знак за знаком и сохраняет разметку страницы. Для многостраничных сканов и архивов она быстрее, а сомнительные символы многие программы подсвечивают.
- Ориентир
- Бесплатные и платные версии, цена зависит от лицензии
- Даёт
- Пакетную обработку многостраничных PDFСохранение колонок, шрифтов и полейРаботу без интернета в версиях для ПК
- Не даёт
- Уверенного чтения рукописного текстаПеревода и конспекта по запросуУстойчивости к бликам и изгибу листа
Набор вручную
Две-три строки быстрее перепечатать, чем снять, загрузить и сверить. Вручную надёжнее разобрать и короткую неразборчивую запись, если рядом автор, который подскажет слово.
- Ориентир
- Без затрат, но каждая страница стоит времени набора
- Даёт
- Контроль каждого символа при набореНикаких загрузок чужих данныхСкорость на двух-трёх строках текста
- Не даёт
- Скорости на многостраничном текстеЗащиты от опечаток при набореТаблиц и перевода без лишней работы
Тарифы: что входит в подписку
Обращения к внешним моделям (GPT, Claude, Nano Banana и другие) списывают токены, обращения к собственным моделям 24AI — операции.
Пробный
0 ₽ Доступ на 24 часа
50токенов
Начать бесплатно - 12 операций
- Один пользователь в аккаунте
Стартовый
999 ₽ / мес
500токенов 500 операций
Выбрать тариф - Доступ к моделям из каталога 24AI
- Все 35 инструментов раздела
- Лимит на текстовые модели 20 запросов в час, 120 в сутки*
- Один пользователь в аккаунте
Базовый
1 999 ₽ / мес
1 500токенов Безлимит операций
Выбрать тариф - Все возможности «Стартового» тарифа
- Все 35 инструментов раздела
- Лимит на текстовые модели 40 запросов в час, 240 в сутки*
- Один пользователь в аккаунте
Профессиональный
3 999 ₽ / мес
3 500токенов Безлимит операций
Выбрать тариф - Все возможности «Базового» тарифа
- Лимит на текстовые модели 60 запросов в час, 360 в сутки*
- До трёх пользователей в аккаунте
- Ключ к API: 5 запросов в секунду
- Пакетная инфографика для карточек
* Лимит не распространяется на GPT 5.4 Pro, GPT 5.5 Pro, Claude 5 Fable и Claude 5.1 Fable: обращения к ним оплачиваются токенами.
Тарифы и токены для распознавания
Распознавание списывает токены — текст со снимка читает внешняя мультимодальная модель. Операции расходуются на собственные модели 24AI, которыми снимок готовят: увеличение разрешения, удаление фона. Стоимость запроса в токенах указана в сервисе.
Лимиты тарифов
- Пробный
- 12 операций · 50 токенов
- Стартовый
- 20 запросов в час, 120 в сутки · 500 токенов
- Базовый
- 40 запросов в час, 240 в сутки · 1 500 токенов
- Профессиональный
- 60 запросов в час, 360 в сутки · 3 500 токенов
Распознавание для команды и потока документов
Бухгалтерии, кафедре или отделу продаж нужен общий аккаунт и повторяемый порядок действий: распознавание соединяется с переводом или сведением в таблицу в одну цепочку «Пайплайнов».
- 01
Общий аккаунт
На «Профессиональном» в аккаунте работают до 3 пользователей с общим пакетом токенов и общей историей генераций.
- 02
Цепочка в «Пайплайнах»
Распознавание, перевод и сведение в таблицу идут одним запуском, а не тремя подряд.
- 03
Пачка страниц за прогон
Нода «Список» подаёт в собранную цепочку до 40 файлов за один прогон, условия распознавания общие.
- Бухгалтерия: чеки и накладные в таблицу
- Кафедра: конспекты и слайды в текст
- Юристы: сканы договоров для поиска
- Продажи: визитки в список контактов
Сканы с данными сотрудников и клиентов — это обработка персональных данных: основание и согласие обеспечивает организация, сервис их не заменяет.
Другие инструменты для текста и фото
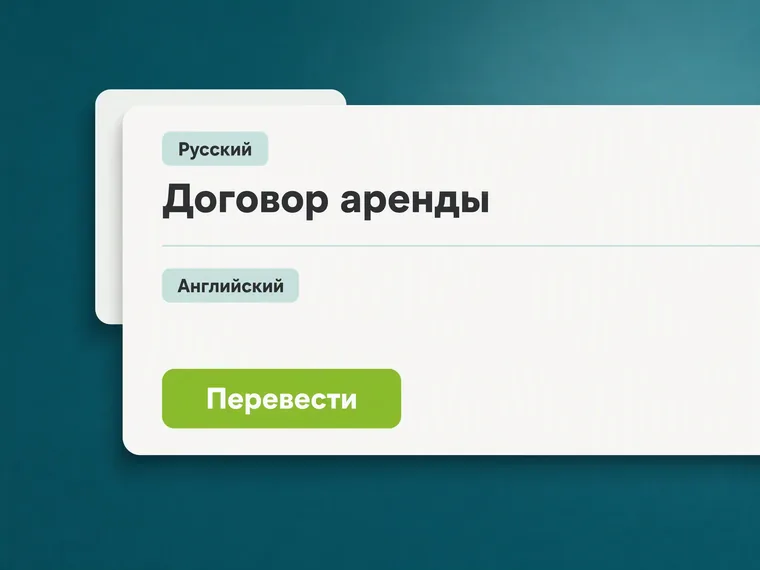
Перевести текст с фото
Перевод надписи, меню или страницы по снимку
Открыть
Решить задачу по фото
Разбор задачи из учебника с ходом решения
Открыть
Улучшить качество фото
Резкость и контраст для размытого снимка
Открыть
Реставрировать старое фото
Восстановление выцветших старых снимков
Открыть
Убрать текст с картинки
Чистое изображение без надписей и подписей
ОткрытьВопросы о распознавании текста с фото
Вопрос не из списка — пишите на support@24ai.tech
Распознаёт ли нейросеть рукописный текст?
Да, мультимодальные модели читают рукописный текст, но точность зависит от почерка и контраста. Чем разборчивее буквы, тем реже модель достраивает слово по смыслу. Попросите её помечать сомнительные слова знаком [?] и сверьте их по приёмам из шага «Сверка спорных мест и цифр».
Какие файлы можно загрузить для распознавания?
Сервис принимает изображения JPG, PNG, WEBP и HEIC — формат фото на iPhone — размером до 15 МБ. PDF-скан сначала сохраните как изображения: нужные страницы экспортируйте в JPG или PNG средствами просмотрщика или сделайте их скриншоты.
Как распознать многостраничный документ?
Загружайте по одной странице на запрос и указывайте её номер. После последней страницы попросите модель собрать текст целиком в исходном порядке. Для архива из десятков страниц программа OCR с пакетной обработкой PDF окажется быстрее — сравнение способов приведено в блоке о стоимости.
Сохранится ли таблица после распознавания?
Да, если попросить об этом в запросе: модель оформит строки и столбцы таблицей. Для вставки в Excel попросите значения через точку с запятой и разбейте их командой «Текст по столбцам». Объединённые ячейки и пустые клетки чаще всего дают сдвиг значений, поэтому проверьте их первыми.
На каких языках нейросеть распознаёт текст?
На русском, английском и других языках, которые поддерживает выбранная модель, включая страницы с двумя языками сразу. Язык распознанного текста совпадает с оригиналом, пока вы не попросите перевод. Для дореформенной орфографии укажите в запросе, сохранять ли старые буквы.
Можно ли распознать текст бесплатно?
Да, на тарифе «Пробный»: 0 ₽, 24 часа после регистрации, 50 токенов и 12 операций, без оплаты. Распознавание расходует токены, стоимость запроса указана в сервисе перед отправкой. Точное число страниц на пробном доступе зависит от выбранной модели, поэтому мы его не обещаем.
Работает ли сервис из России без VPN?
Да, 24AI работает из России в браузере без VPN. Оплата принимается картами российских и зарубежных банков и через СБП. Войти можно через Точка ID, Яндекс ID и VK ID.
Что происходит с загруженным фото?
Файл обрабатывается по правилам политики конфиденциальности 24AI, договор на использование сервиса заключается с ООО «Архивариус». Права на созданный в сервисе текст принадлежат владельцу аккаунта. Подробности о реквизитах и документах собраны в блоке о хранении фото.
Можно ли распознать паспорт или СНИЛС?
Технически да, но загружать можно только свои документы или документы с согласия владельца. Распознанный текст не заменяет копию и не имеет её юридической силы. Каждую цифру серии, номера и даты сверьте с оригиналом: ошибка в одном символе делает данные недействительными.
Можно ли опубликовать распознанный текст книги?
Без разрешения правообладателя — нет: распознавание не переносит права на произведение. Для личной работы страницу распознать можно. Цитаты в реферате, статье или обзоре допустимы по статье 1274 ГК РФ в объёме, оправданном целью цитирования, со ссылкой на автора и источник.
Как распознать текст с экрана или из видео?
Сделайте скриншот и загрузите его как изображение. С видео остановите кадр с нужным текстом или субтитрами и снимите скриншот. Фото экрана на камеру даёт муар — рябь от пикселей, — и модель ошибается чаще.
Чем нейросеть отличается от распознавания в камере телефона?
Для пары строк встроенной функции камеры хватит, и платить за неё не нужно. Нейросеть полезна, когда нужна структура: абзацы, таблица, нумерация пунктов. В том же чате её можно попросить перевести текст, свести чек в таблицу или сократить конспект.