


Claude Opus
Долгие задачи: анализ, тесты, сложные правки
- Длинный контекст
- Ход рассуждения
Списание — операции
Код и разработка
GPT 5, Claude, Gemini, DeepSeek, Qwen и другие пишут код, ищут причину ошибки и разбирают чужой проект. Разработчикам, аналитикам и студентам — доступ без VPN, оплата картой РФ и СБП, регистрация в 24AI.
Пробный тариф — 0 ₽ на 24 часа: 50 токенов, 12 операций, один пользователь.
Собери CLI на Python для разбора логов nginx
Вот готовый CLI-инструмент для разбора логов nginx на чистом Python (без внешних зависимостей — только стандартная библиотека). Поддерживает combined/common формат, произвольный regex, gzip, фильтры по датам/IP/статусам/пути/UA, а также агрегации (топ IP, топ URL, статусы, трафик по часам, медленные запросы) и вывод в table/json/csv.
Состав каталога обновляем при выходе новых версий; прямой чат с моделью списывает операцию и почасовой лимит запросов, а не токены.
Долгие задачи: анализ, тесты, сложные правки
Списание — операции
Новый код и правки в больших файлах проекта
Списание — операции
Задачи, где важен ход рассуждения модели
Списание — операции
Рутинные правки и генерация типового кода
Списание — операции
Работа с длинным контекстом и вложениями
Списание — операции
Быстрые подсказки по ходу написания кода
Списание — операции
Универсальная работа: код, тесты, документация
Списание — операции
Скрипты автоматизации и работа с данными
Списание — операции
Под каждую задачу указана одна модель, а не список из трёх: выбор уже сделан. Рядом — причина и ограничение, о котором стоит знать до того, как код уйдёт в проект.
Держит структуру длинного файла: дописывает функции и не переписывает то, что уже работает.
Код модель не запускает и зависимостей ваших не видит: сборку и тесты прогоняете сами.
Показывает ход рассуждения — видно, на каком допущении модель свернула не туда.
Без текста ошибки, версии библиотеки и команды запуска ответ будет общим, а не про ваш случай.
Принимает крупные файлы и скриншоты, отвечает по структуре модуля и связям между функциями.
Видит только приложенные файлы: репозиторий целиком и историю коммитов модель не читает.
Переносит поведение, а не строки: подбирает идиомы принимающего языка и типовые библиотеки.
Сборку, менеджер пакетов и переменные окружения под новый язык настраивает разработчик.
Разбирает ветвления и предлагает граничные случаи, а не один сценарий, где всё проходит.
Покрытие считает ваш CI: какие ветки кода выполняются на самом деле, модель не знает.
| Свойство | GPT 5 Перевести код на другой язык | Claude Opus Закрыть код юнит-тестами | Gemini Pro Разобраться в чужом проекте | DeepSeek V4 Pro Найти причину ошибки в коде |
|---|---|---|---|---|
| Кто разработал | OpenAI | Anthropic | DeepSeek | |
| Специализация | универсальная | универсальная | универсальная | рассуждающая |
| Ввод скриншота | есть | есть | есть | нет |
| Ход рассуждения | скрыт | скрыт | скрыт | виден |
| Открытые веса | нет | нет | нет | есть |
| Единица оплаты | операции | операции | операции | операции |
Перевести код на другой язык
Закрыть код юнит-тестами
Разобраться в чужом проекте
Найти причину ошибки в коде
Состав моделей и стоимость запросов задаёт Лицензиар и показывает в Сервисе; сравнение обновляем при выходе новых версий моделей.
Три ограничения, из-за которых код чаще всего приходится переделывать, и рабочий обходной путь для каждого.
Войдите в app.24ai.tech через Точка ID, Яндекс ID либо VK ID. Установка программы не нужна: сервис работает в браузере.
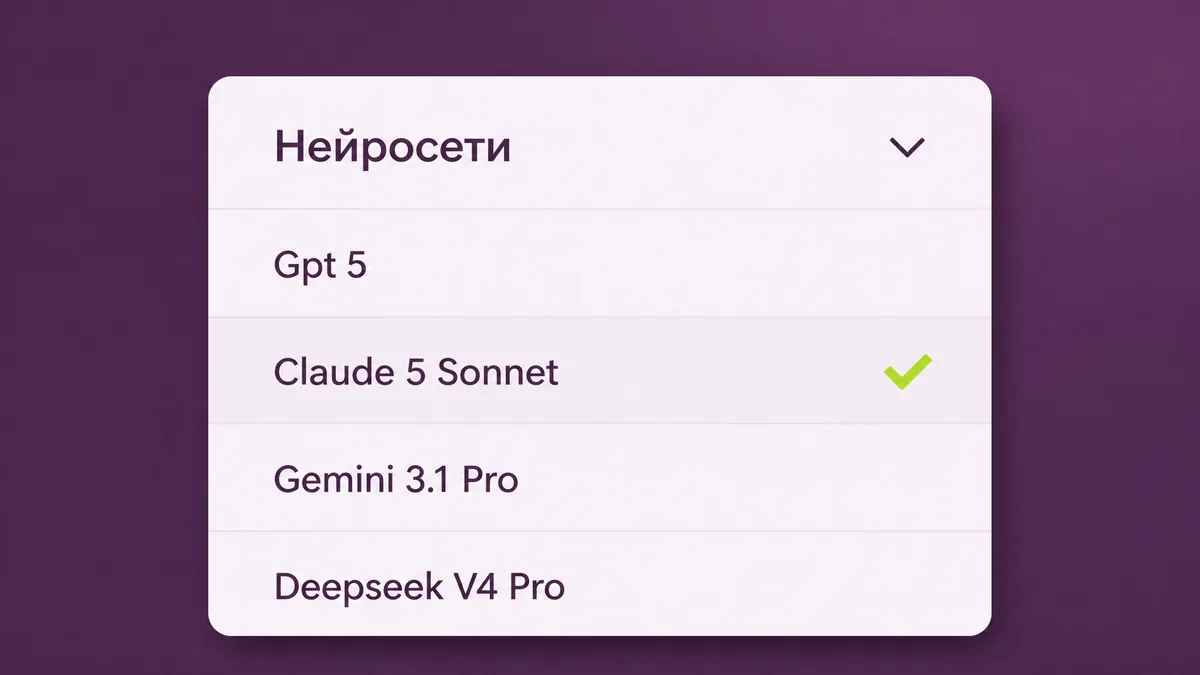
Откройте раздел «Нейросети» или «Пайплайны» и выберите модель из каталога. Переключаться между GPT 5, Claude, Gemini, DeepSeek и другими моделями можно в одном диалоге, аккаунты у вендоров не нужны.
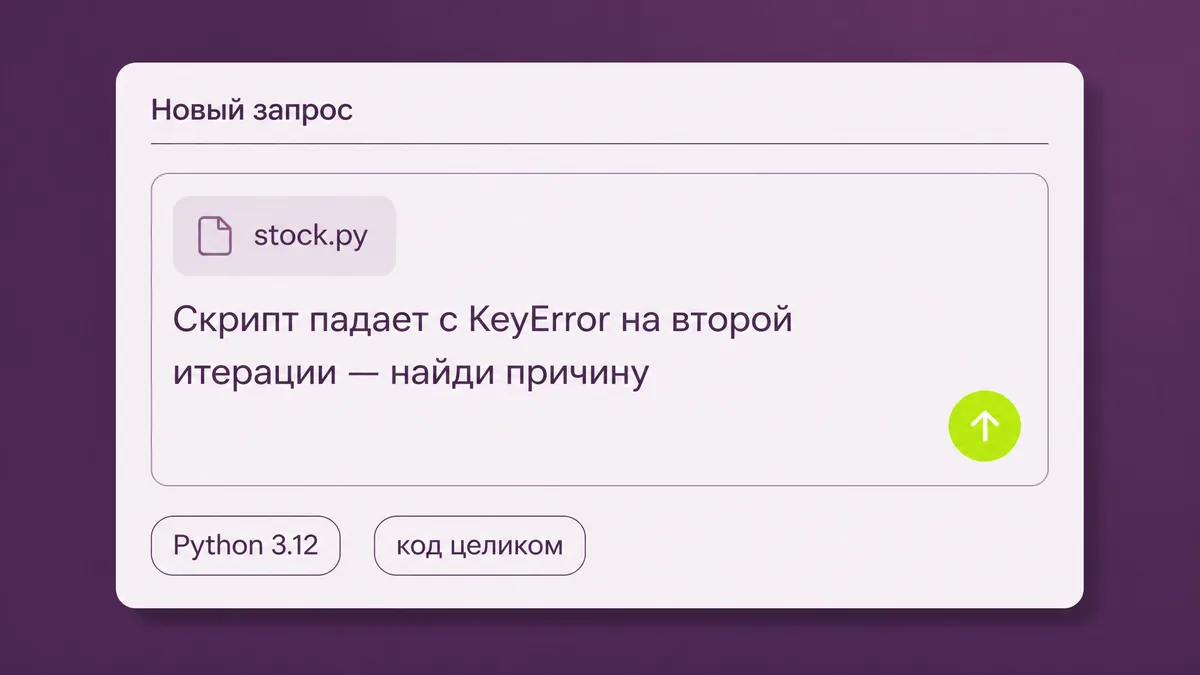
Опишите задачу на русском: язык, версию, фреймворк и ожидаемое поведение. Готовый код, текст ошибки или скриншот прикладываются к тому же запросу.
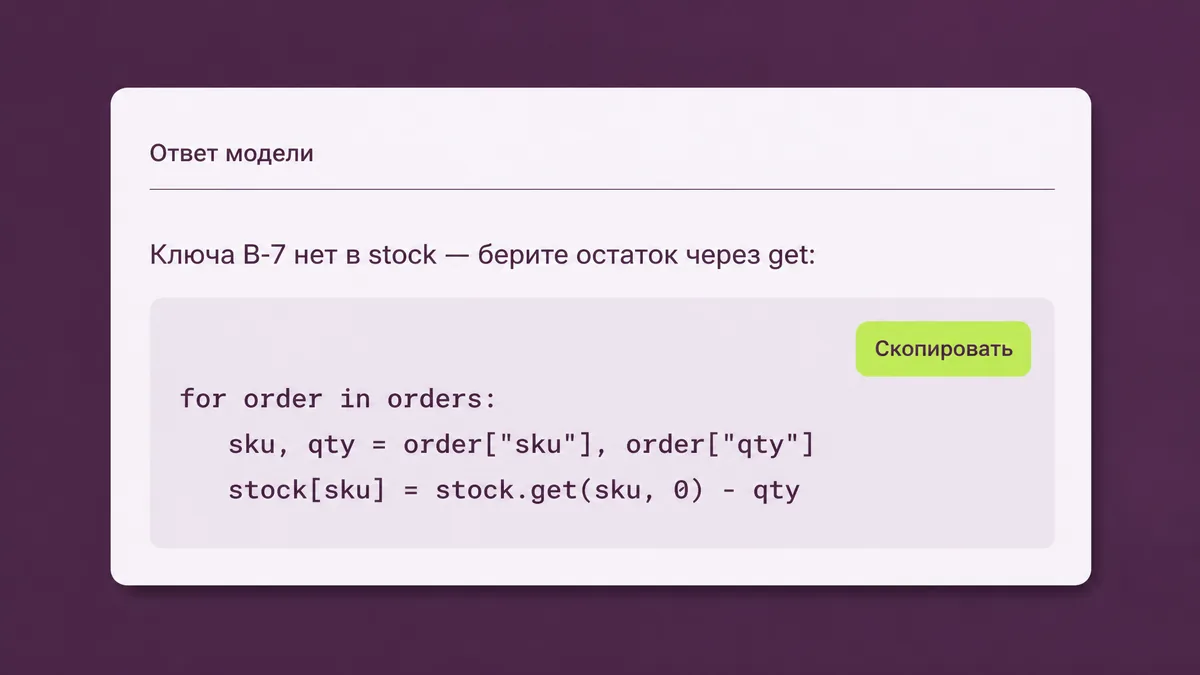
Скопируйте ответ, уточните его повторным запросом и заберите код в проект. Исключительные права на результат принадлежат владельцу аккаунта.
Пробный тариф — 0 ₽ на 24 часа: 50 токенов, 12 операций, один пользователь.
У текстовых моделей в чате на «Базовом» — 40 запросов в час и 240 в сутки, на «Стартовом» — 20 и 120. GPT 5.4 Pro, GPT 5.5 Pro, Claude 5 Fable и 5.1 Fable в эти лимиты не входят.
Лимит текстовых моделей в чате — 20 запросов в час на «Стартовом», 40 на «Базовом» и 60 на «Профессиональном».
Скриншот ошибки или таблицу принимаем в JPG, PNG, WEBP и HEIC размером до 15 МБ; код и трассировку вставляйте текстом.
Напиши на FastAPI эндпоинт загрузки файла с проверкой размера и типа

Python 3.12, FastAPI. Принимай PNG и JPEG до 5 МБ, на остальное отвечай ошибкой 400.

Код пришли одним блоком кода целиком.Ответ
from fastapi import FastAPI, File, UploadFile, HTTPException
from fastapi.responses import JSONResponse

app = FastAPI()

MAX_SIZE_BYTES = 5 * 1024 * 1024  # 5 MB
CHUNK_SIZE = 64 * 1024  # 64 KB

PNG_SIGNATURE = b"\x89PNG\r\n\x1a\n"
JPEG_SOI = b"\xff\xd8"  # Start Of Image


def sniff_image_type(initial_bytes: bytes) -> str | None:
    # Check PNG signature (first 8 bytes)
    if initial_bytes.startswith(PNG_SIGNATURE):
        return "image/png"
    # Check JPEG signature (starts with 0xFFD8)
    if initial_bytes.startswith(JPEG_SOI):
        return "image/jpeg"
    return None


@app.post("/upload")
async def upload_image(file: UploadFile = File(...)):
    """
    Accepts PNG and JPEG up to 5 MB.
    Returns 400 for any other file type or if size exceeds 5 MB.
    """
    total_read = 0
    first_chunk = b""

    try:
        # Read the first chunk to determine type and start counting size
        first_chunk = await file.read(CHUNK_SIZE)
        total_read += len(first_chunk)

        if not first_chunk:
            raise HTTPException(status_code=400, detail="Файл пустой или не был загружен.")

        detected_type = sniff_image_type(first_chunk)
        if detected_type not in {"image/png", "image/jpeg"}:
            raise HTTPException(status_code=400, detail="Разрешены только PNG и JPEG.")

        if total_read > MAX_SIZE_BYTES:
            raise HTTPException(status_code=400, detail="Файл превышает максимально допустимый размер 5 МБ.")

        # Continue reading the rest to enforce size limit
        while True:
            chunk = await file.read(CHUNK_SIZE)
            if not chunk:
                break
            total_read += len(chunk)
            if total_read > MAX_SIZE_BYTES:
                raise HTTPException(status_code=400, detail="Файл превышает максимально допустимый размер 5 МБ.")

        # If needed, here you could store the file; currently just validates and acknowledges upload.
        return JSONResponse(
            {
                "filename": file.filename,
                "content_type": detected_type,
                "size_bytes": total_read,
                "detail": "Загрузка прошла успешно.",
            }
        )
    finally:
        # Ensure the temporary file is closed
        await file.close()


# For local testing: uvicorn this_module:app --reload
if __name__ == "__main__":
    import uvicorn

uvicorn.run(app, host="127.0.0.1", port=8000)Перепиши класс так, чтобы он не зависел от глобального конфига
import config
class ReportSender:
def send(self, report):
if not config.SETTINGS["reports_enabled"]:
return False
client = SmtpClient(config.SETTINGS["smtp_host"], config.SETTINGS["smtp_port"])
client.send(to=config.SETTINGS["report_email"], body=report.render())
return True
Код пришли одним блоком кода целиком.Ответ
class ReportSender:
    def __init__(self, reports_enabled: bool, smtp_host: str, smtp_port: int, report_email: str, smtp_client_factory=SmtpClient):
        self.reports_enabled = reports_enabled
        self.smtp_host = smtp_host
        self.smtp_port = smtp_port
        self.report_email = report_email
        self.smtp_client_factory = smtp_client_factory

    def send(self, report):
        if not self.reports_enabled:
            return False

        client = self.smtp_client_factory(self.smtp_host, self.smtp_port)
        client.send(to=self.report_email, body=report.render())
        return True


Использование (конфиг передаётся снаружи, при создании объекта):


import config

sender = ReportSender(
    reports_enabled=config.SETTINGS["reports_enabled"],
    smtp_host=config.SETTINGS["smtp_host"],
    smtp_port=config.SETTINGS["smtp_port"],
    report_email=config.SETTINGS["report_email"],
)
sender.send(report)


Теперь ReportSender не импортирует и не знает о config напрямую — все зависимости передаются через конструктор, что упрощает тестирование (можно передать фейковый smtp_client_factory и произвольные настройки) и снижает связанность с глобальным состоянием.Скрипт падает с KeyError на второй итерации — найди причину
stock = {"A-1": 10}
orders = [{"sku": "A-1", "qty": 3}, {"sku": "B-7", "qty": 1}]
for order in orders:
stock[order["sku"]] -= order["qty"]
print(order["sku"], stock[order["sku"]])
Traceback (most recent call last):
File "stock.py", line 4, in <module>
stock[order["sku"]] -= order["qty"]
KeyError: 'B-7'
Код пришли одним блоком кода целиком.Ответ
Причина ошибки: на второй итерации в словаре stock нет ключа "B-7". Операция stock[order["sku"]] -= order["qty"] сначала читает значение по ключу (stock["B-7"]), а только потом вычитает и записывает обратно. Так как ключа нет — возникает KeyError.

Исправленный вариант (неизвестный SKU считается нулевым остатком):


stock = {"A-1": 10}

orders = [
    {"sku": "A-1", "qty": 3},
    {"sku": "B-7", "qty": 1},
]

for order in orders:
    sku = order["sku"]
    stock[sku] = stock.get(sku, 0) - order["qty"]
    print(sku, stock[sku])


Результат выполнения:


A-1 7
B-7 -1


Если отрицательные остатки недопустимы, можно добавить проверку и пропускать такие позиции:


stock = {"A-1": 10}

orders = [
    {"sku": "A-1", "qty": 3},
    {"sku": "B-7", "qty": 1},
]

for order in orders:
    sku = order["sku"]
    if sku not in stock:
        print(f"Пропуск: {sku} отсутствует на складе")
        continue
    if stock[sku] < order["qty"]:
        print(f"Пропуск: {sku} недостаточно остатка")
        continue
    stock[sku] -= order["qty"]
print(sku, stock[sku])Объясни, что делает этот модуль, и перечисли его зависимости
import csv
from datetime import date
import requests
API = "https://api.example.com/rates"
def load_rates(day: date) -> dict:
r = requests.get(API, params={"date": day.isoformat()}, timeout=10)
r.raise_for_status()
return {row["code"]: row["rate"] for row in r.json()["items"]}
def export_prices(path: str, prices: dict, rates: dict) -> None:
with open(path, "w", newline="", encoding="utf-8") as f:
w = csv.writer(f, delimiter=";")
w.writerow(["sku", "rub", "usd"])
for sku, rub in prices.items():
w.writerow([sku, rub, round(rub / rates["USD"], 2)])Ответ
Этот модуль предназначен для получения курсов валют из внешнего API и экспорта списка цен товаров в CSV-файл с автоматическим пересчетом стоимости из рублей в доллары (USD).

Вот подробное описание того, как работают его функции:

load_rates(day: date) -> dict:

Обращается к внешнему API (https://api.example.com/rates), передавая ему конкретную дату.
Ожидает ответа не дольше 10 секунд (параметр timeout=10). Если возникает ошибка HTTP (например, 404 или 500), функция выбросит исключение с помощью r.raise_for_status().
Извлекает JSON-данные из ответа и собирает словарь (dictionary), где ключами являются коды валют (code), а значениями — их курсы (rate).

export_prices(path: str, prices: dict, rates: dict) -> None:

Создает или перезаписывает текстовый файл по указанному пути path в кодировке utf-8.
Записывает в него данные в формате CSV, используя точку с запятой (;) в качестве разделителя.
Сначала записывает строку с заголовками колонок: sku (артикул), rub (цена в рублях), usd (цена в долларах).
Затем проходит по словарю prices, берет цену в рублях, делит её на курс доллара из словаря rates["USD"], округляет результат до двух знаков после запятой и записывает все три значения (артикул, рубли, доллары) новой строкой в файл.
Зависимости модуля:

Встроенные библиотеки Python (не требуют установки):

csv — для записи данных в формате CSV.
datetime (а именно класс date) — для работы с датами и форматирования даты для API-запроса (isoformat()).

Сторонние библиотеки (требуют установки через pip):

requests — для выполнения HTTP-запросов к API. (Устанавливается командой pip install requests).Допиши юнит-тесты к функции: граничные случаи и пустой ввод
def split_price(total: int, parts: int) -> list[int]:
if parts <= 0:
raise ValueError("parts must be positive")
base, rest = divmod(total, parts)
return [base + 1 if i < rest else base for i in range(parts)]
Тесты на pytest.
Код пришли одним блоком кода целиком.Ответ
# test_split_price.py
import pytest

from split_price import split_price  # замените на реальный путь импорта


# ---------------------------------------------------------------------------
# 1. Базовое поведение
# ---------------------------------------------------------------------------

@pytest.mark.parametrize(
    "total, parts, expected",
    [
        (10, 1, [10]),
        (10, 2, [5, 5]),
        (10, 3, [4, 3, 3]),
        (10, 4, [3, 3, 2, 2]),
        (100, 3, [34, 33, 33]),
        (7, 7, [1, 1, 1, 1, 1, 1, 1]),
        (1, 3, [1, 0, 0]),
        (2, 3, [1, 1, 0]),
    ],
)
def test_exact_distribution(total, parts, expected):
    assert split_price(total, parts) == expected


# ---------------------------------------------------------------------------
# 2. Невалидный ввод: parts <= 0
# ---------------------------------------------------------------------------

@pytest.mark.parametrize("parts", [0, -1, -2, -100])
def test_non_positive_parts_raises(parts):
    with pytest.raises(ValueError, match="parts must be positive"):
        split_price(100, parts)


def test_zero_parts_raises_even_for_zero_total():
    """«Пустой ввод»: нечего делить и не на что — всё равно ValueError."""
    with pytest.raises(ValueError, match="parts must be positive"):
        split_price(0, 0)


def test_error_raised_before_any_computation():
    """Проверка порядка: исключение, а не деление на ноль (ZeroDivisionError)."""
    with pytest.raises(ValueError):
        split_price(10, 0)


# ---------------------------------------------------------------------------
# 3. Нулевой / пустой total
# ---------------------------------------------------------------------------

@pytest.mark.parametrize("parts", [1, 2, 5, 100])
def test_zero_total_gives_all_zeros(parts):
    result = split_price(0, parts)
    assert result == [0] * parts
    assert sum(result) == 0


def test_total_less_than_parts():
    """Часть получателей получает 0 — список не «схлопывается»."""
    result = split_price(3, 10)
    assert result == [1, 1, 1, 0, 0, 0, 0, 0, 0, 0]
    assert len(result) == 10


# ---------------------------------------------------------------------------
# 4. Граничные случаи по размеру
# ---------------------------------------------------------------------------

def test_single_part_returns_whole_total():
    assert split_price(999_999, 1) == [999_999]


def test_large_parts_count():
    parts = 10_000
    result = split_price(12_345, parts)
    assert len(result) == parts
    assert sum(result) == 12_345
    assert set(result) == {1, 2}


def test_large_total():
    total, parts = 10**18 + 7, 3
    result = split_price(total, parts)
    assert sum(result) == total
    assert max(result) - min(result) <= 1


# ---------------------------------------------------------------------------
# 5. Отрицательный total (документируем текущее поведение divmod)
# ---------------------------------------------------------------------------

@pytest.mark.parametrize(
    "total, parts, expected",
    [
        (-10, 2, [-5, -5]),
        (-10, 3, [-3, -3, -4]),   # divmod(-10, 3) == (-4, 2)
        (-1, 3, [0, 0, -1]),
    ],
)
def test_negative_total_behaviour(total, parts, expected):
    assert split_price(total, parts) == expected
    assert sum(expected) == total


# ---------------------------------------------------------------------------
# 6. Инварианты (свойства функции)
# ---------------------------------------------------------------------------

CASES = [(t, p) for t in (0, 1, 2, 7, 10, 99, 1000, -7) for p in (1, 2, 3, 5, 7, 11)]


@pytest.mark.parametrize("total, parts", CASES)
def test_sum_is_preserved(total, parts):
    assert sum(split_price(total, parts)) == total


@pytest.mark.parametrize("total, parts", CASES)
def test_length_equals_parts(total, parts):
    assert len(split_price(total, parts)) == parts


@pytest.mark.parametrize("total, parts", CASES)
def test_difference_at_most_one(total, parts):
    result = split_price(total, parts)
    assert max(result) - min(result) <= 1


@pytest.mark.parametrize("total, parts", CASES)
def test_result_is_non_increasing(total, parts):
    """Остаток раздаётся первым элементам, поэтому список не возрастает."""
    result = split_price(total, parts)
    assert result == sorted(result, reverse=True)


@pytest.mark.parametrize("total, parts", CASES)
def test_all_items_are_ints(total, parts):
    result = split_price(total, parts)
    assert isinstance(result, list)
    assert all(isinstance(x, int) and not isinstance(x, bool) for x in result)


@pytest.mark.parametrize("total, parts", CASES)
def test_deterministic(total, parts):
    assert split_price(total, parts) == split_price(total, parts)


def test_result_is_fresh_list_each_call():
    """Мутация результата не влияет на последующие вызовы."""
    first = split_price(10, 3)
    first[0] = 999
    assert split_price(10, 3) == [4, 3, 3]


# ---------------------------------------------------------------------------
# 7. Типы аргументов
# ---------------------------------------------------------------------------

def test_bool_parts_is_treated_as_one_part():
    """bool — подкласс int; True == 1, поведение не должно падать."""
    assert split_price(10, True) == [10]


def test_false_parts_raises():
    with pytest.raises(ValueError, match="parts must be positive"):
        split_price(10, False)


@pytest.mark.parametrize("bad", [None, "3", 3.5, [3], {}])
def test_non_int_parts_raises_type_error(bad):
    with pytest.raises((TypeError, ValueError)):
        split_price(10, bad)


@pytest.mark.parametrize("bad", [None, "10", [10], {}])
def test_non_int_total_raises_type_error(bad):
    with pytest.raises(TypeError):
split_price(bad, 3)Переведи скрипт с Bash на Python без внешних зависимостей
#!/bin/bash
for f in logs/*.log; do
count=$(grep -c "ERROR" "$f")
if [ "$count" -gt 0 ]; then
echo "$f: $count"
fi
done
Код пришли одним блоком кода целиком.Ответ
#!/usr/bin/env python3
import glob

def main():
    for path in sorted(glob.glob("logs/*.log")):
        try:
            with open(path, "r", encoding="utf-8", errors="replace") as f:
                count = sum(1 for line in f if "ERROR" in line)
        except OSError:
            # If a file can't be read, skip it (similar to grep erroring out and producing no count)
            continue

        if count > 0:
            print(f"{path}: {count}")

if __name__ == "__main__":
main()Напиши регулярку для российских номеров и покажи примеры
Номера пишут как +7 900 123-45-67, 8 (900) 123-45-67 и 89001234567. Регулярку и проверку на Python пришли одним блоком кода.Ответ
Вот регулярное выражение и скрипт на Python с проверкой различных форматов:


import re

# Регулярное выражение для валидации российских номеров:
# - Поддерживает префикс +7 или 8
# - Код города/оператора может быть в скобках: (900) или без: 900
# - Разделители: пробелы, дефисы или их отсутствие
pattern = re.compile(
    r"^(?:\+7|8)[\s-]?(?:\((\d{3})\)|(\d{3}))[\s-]?(\d{3})[\s-]?(\d{2})[\s-]?(\d{2})$"
)

# Тестовые номера
test_phones = [
    # Корректные форматы
    "+7 900 123-45-67",
    "8 (900) 123-45-67",
    "89001234567",
    "+7(900)1234567",
    "+7 900 123 45 67",
    "8-900-123-45-67",
    "+79001234567",
    # Некорректные форматы
    "9001234567",  # нет кода страны (+7 или 8)
    "+7 (900 123-45-67",  # незакрытая скобка
    "+7 900 123-45-6",  # не хватает цифры
    "+7 900 123-45-678",  # лишняя цифра
    "+1 900 123-45-67",  # код другой страны
]


def normalize_phone(phone: str) -> str | None:
    """Проверяет номер и приводит его к единому формату +7 (XXX) XXX-XX-XX."""
    match = pattern.match(phone.strip())
    if not match:
        return None

    # Извлекаем группы цифр
    code = match.group(1) or match.group(2)
part1, part2, part3 = match.group(3), match.group(4Добавь обработку ошибок и логирование в этот HTTP-клиент
import requests
def get_order(order_id):
r = requests.get(f"https://api.example.com/orders/{order_id}")
return r.json()
Код пришли одним блоком кода целиком.Ответ
import logging
import requests
from requests.exceptions import RequestException, Timeout, HTTPError, ConnectionError

# Настройка логирования
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s - %(name)s - %(levelname)s - %(message)s",
)
logger = logging.getLogger(__name__)

API_BASE_URL = "https://api.example.com"
TIMEOUT_SECONDS = 10


def get_order(order_id):
    url = f"{API_BASE_URL}/orders/{order_id}"
    logger.info("Запрос заказа: order_id=%s, url=%s", order_id, url)

    try:
        r = requests.get(url, timeout=TIMEOUT_SECONDS)

        # Прокидываем ошибку для не-2xx статусов
        r.raise_for_status()

        try:
            data = r.json()
        except ValueError:
            logger.error(
                "Некорректный JSON в ответе для order_id=%s, status=%s, body=%r",
                order_id, r.status_code, r.text[:500],
            )
            raise ValueError(f"Некорректный JSON в ответе для заказа {order_id}")

        logger.info("Заказ получен: order_id=%s, status=%s", order_id, r.status_code)
        return data

    except Timeout:
        logger.error("Таймаут запроса: order_id=%s (лимит %s с)", order_id, TIMEOUT_SECONDS)
        raise TimeoutError(f"Запрос заказа {order_id} превысил таймаут {TIMEOUT_SECONDS} с")

    except ConnectionError:
        logger.error("Ошибка соединения: order_id=%s, url=%s", order_id, url)
        raise ConnectionError(f"Не удалось соединиться с API для заказа {order_id}")

    except HTTPError as e:
        logger.error(
            "HTTP-ошибка: order_id=%s, status=%s, reason=%s",
            order_id, r.status_code, r.reason,
        )
        raise RuntimeError(
            f"API вернул ошибку {r.status_code} ({r.reason}) для заказа {order_id}"
        ) from e

    except RequestException as e:
        logger.exception("Неизвестная ошибка запроса: order_id=%s", order_id)
        raise RuntimeError(f"Ошибка запроса для заказа {order_id}: {e}") from e


Что добавлено:

Логирование — через logging с форматированием (время, уровень, сообщение). Логируется начало запроса, успешный ответ и все ошибки (с контекстом: order_id, статус, тело ответа при проблемах с JSON).

Обработка ошибок:

Timeout → своё понятное исключение TimeoutError;
ConnectionError → ConnectionError с описанием;
HTTPError (через raise_for_status()) → RuntimeError с кодом и причиной;
ValueError при битом JSON в ответе;
RequestException как общий «предохранитель» (любая другая ошибка requests).

Таймаут — запрос больше не может «висеть» бесконечно (timeout=10).

Отдельный logger — удобно подключать к любому фреймворку логирования, а не засорять глобальный логгер.Четыре правила, которые сокращают число уточняющих итераций. Проверить формулировку можно на инструменте генерации промптов.
«Python 3.12, Django 5, PostgreSQL 16» вместо «на питоне»: модель подставит актуальный синтаксис, а не усреднённый по всем версиям.
Что приходит на вход, что должно вернуться, что делать при пустом значении и ошибке — иначе модель придумает эти условия сама.
Трассировку целиком, команду запуска и версию библиотеки. По одной строке «не работает» модель отвечает общими рекомендациями.
Публичный интерфейс, имена полей в базе, стиль кода, запрещённые зависимости — всё, что вы не готовы переписывать после ответа.
Задача словами на входе, готовая функция или скрипт на выходе.
Код и текст ошибки на входе, исправленный вариант с пояснением.
Разбор чужого фрагмента построчно: что делает, где меняется состояние.
Упрощение кода без смены поведения: имена, вложенность, дубли.
Тесты к готовой функции: обычные сценарии и граничные значения.
Проверка правок: риски, стиль и места с изменённым поведением.
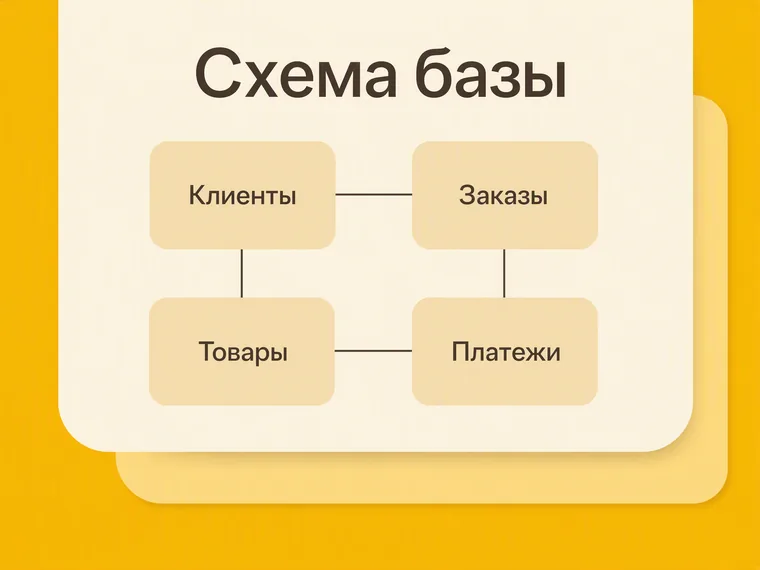
Таблицы, связи и индексы по описанию будущих запросов к базе.
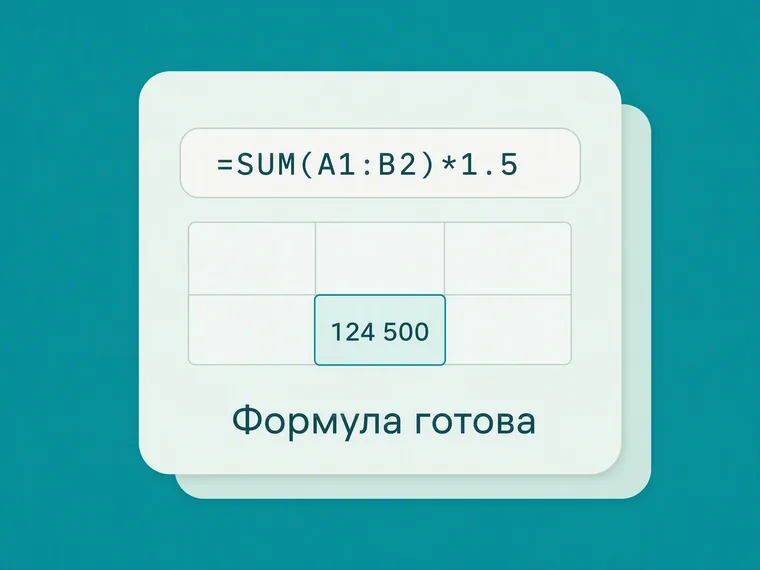
Формула по описанию задачи и разбор аргументов на русском языке.
Состав доступных моделей определяет Лицензиар, актуальный перечень отображается в Сервисе.
| Напрямую |  |
|---|---|
| Оплата: только зарубежная карта | Оплата: карта РФ, СБП или зарубежная |
| Аккаунты: свой у каждого вендора | Аккаунты: один вход на все модели |
| Баланс: подписка на каждый сервис | Баланс: один счёт и пакет токенов |
Прямой чат с моделью в разделе «Нейросети» списывает операцию и почасовой лимит запросов, а не токены; токены расходуются на инструменты для кода и на шаги с внешними моделями в «Пайплайнах». Цены указаны за месяц по действующему прайс-листу.
Лимиты запросов в час и в сутки действуют для текстовых моделей, кроме GPT 5.4 Pro, GPT 5.5 Pro, Claude 5 Fable и 5.1 Fable: за них токены списываются и в чате.
Код, который вы получили в кабинете, принадлежит вам — с этим связаны три условия, зафиксированные в лицензионном договоре.
В сервис загружаются изображения JPG, PNG, WEBP и HEIC до 15 МБ, а также документы и таблицы до 20 МБ для разбора. Файлы и запросы обрабатываются, чтобы выполнить вашу задачу и показать результат в кабинете. Правила работы с данными описаны в политике конфиденциальности.
Запросы и файлы обрабатывает внешняя модель на стороне своего разработчика — OpenAI, Anthropic, Google и других. Поэтому пароли, токены и ключи доступа, сведения под коммерческой тайной и персональные данные клиентов лучше заменить заглушками до отправки.
Исключительные права на созданный код принадлежат владельцу аккаунта, в котором его сгенерировали. Это зафиксировано в условиях использования сервиса.
Код идёт в коммерческие продукты, во внутренние сервисы и в работы для клиентов без отдельных согласований и выплат за каждое использование.
На программу «24ИИ»/«24AI» вы получаете простую неисключительную лицензию. Права на то, что вы в ней создали, остаются вашими и лицензией не ограничены.
Несколько моделей соединяются в цепочку: описание задачи, затем код, затем тесты и текст для документации.
Один аккаунт на трёх человек: общий баланс токенов, общая история запросов и одинаковый доступ к моделям.
Тарифы и цены 24AIНет. Модели открываются в браузере по адресу app.24ai.tech, отдельные аккаунты у OpenAI, Google, Anthropic и других вендоров заводить не нужно. Вход и оплата идут на стороне 24AI, интерфейс русский.
В разделах «Нейросети» и «Пайплайны» вы сами выбираете модель и формулируете запрос — это свободный диалог. Инструменты для кода — это готовые сценарии с подготовленными промптами: вставили код, получили результат. Списание разное: прямой чат с моделью — операция и почасовой лимит запросов, инструмент — токены.
Да. Модели каталога понимают запрос на русском и отвечают на русском, переводить его не нужно. Английскими оставляйте названия библиотек, методов, флагов и текст ошибки: в переводе модель начинает искать метод, которого не существует.
Да. Скриншот ошибки, фрагмент кода и таблицу можно приложить к запросу: сервис принимает JPG, PNG, WEBP и HEIC размером до 15 МБ. Часть моделей работает только с текстом — тогда вставьте код и трассировку прямо в поле запроса.
Прямой чат с моделью списывает операцию и почасовой лимит запросов, а не токены. Исключение — GPT 5.4 Pro, GPT 5.5 Pro, Claude 5 Fable и 5.1 Fable: за них токены списываются и в чате, цена указана в Сервисе. Пакет токенов тарифа — 500 на «Стартовом», 1 500 на «Базовом», 3 500 на «Профессиональном» — уходит на инструменты для кода.
Неизрасходованные токены остаются на балансе 6 месяцев после окончания оплаченного тарифа, потратить их можно при действующей подписке. Неиспользованные операции на следующий период не переносятся.
Лимит текстовых моделей в чате зависит от тарифа: 20 запросов в час и 120 в сутки на «Стартовом», 40 и 240 на «Базовом», 60 и 360 на «Профессиональном». GPT 5.4 Pro, GPT 5.5 Pro, Claude 5 Fable и 5.1 Fable в эти лимиты не входят и считаются отдельно.
Исключительные права на сгенерированный код принадлежат владельцу аккаунта 24AI, в котором его создали. Код идёт в коммерческие продукты без дополнительных согласований и выплат. Ответственность за законность использования при этом лежит на пользователе.
Нет. Работа идёт в браузере по адресу app.24ai.tech: плагина для IDE и подключения к репозиторию сейчас нет, код вы переносите копированием.
Да, тариф «Пробный»: 0 ₽, 24 часа после регистрации, 50 токенов и 12 операций, один пользователь. Этого хватает, чтобы проверить несколько моделей на своей задаче.